学海无涯

centos7 与 centos stream 发布版本流程对比

Centos7 的替代方案

CentOS 7 是一个开源操作系统。CentOS(Community ENTerprise Operating System)是基于 Red Hat Enterprise Linux (RHEL) 的一个社区版本,旨在提供一个稳定和可靠的企业级操作系统。用户可以自由地下载、使用、修改和分发它的源代码。本人个人服务器也是长期采用此系统,**CentOS 7 Linux 将于 Jun 30th, 2024 EOF(结束生命周期).**

梳理了一下对应的替代方案。

centos OS stream

结论:不建议,根据下面发布流程,Centos stream 优先享受新特性,但是随之,centos stream 也成为了 RHEL 版本的灰度测试,且centos stream 不再提供小版本,导致稳定性不可控。 centos7 与 centos stream 发布版本流程对比

优点 缺点
接近 RHEL:提供新特性,提前体验 相对不稳定性:可能引入不可预见的问题
滚动更新:频繁进行版本更新 缺乏历史小版本:不再提供 7.X 的小版本
快速反馈:可测试新特性并提供反馈 长时间支持有限:不明确的支持期
活跃开发社区:吸引更多开发者参与 社区反应:用户对替代传统 CentOS 的不满
无成本使用:适合成本敏感用户 学习曲线:需要适应滚动更新模型

RHEL Linux

适合用户:

  • 不差钱
  • 对稳定性要求极高
  • 需要购买专业 Linux 维护服务
  • 金融行业

Rocky Linux

  • Rocky Linux 与 RHEL 和 CentOS 的关系

Rocky Linux 是一个基于 Red Hat Enterprise Linux (RHEL) 的开源操作系统,旨在提供一个稳定和免费替代品。它的创建是由于 CentOS 项目转变为 CentOS Stream,这一变化引发了部分用户的不满,因为 CentOS Stream 更加接近于 RHEL 的开发版,而不是稳定的发行版。

F**K ZZZQ - 记录那些因政治正确而改名的技术

0x00

请允许我首先给出一个和善而不失礼貌的微笑 :) 以纪念因为这些莫名其妙的事而浪费的时间。

在今年早些时候乔治-弗洛伊德(George Floyd)的惨死和BLM抗议活动之后,科技公司希望通过放弃master、slave、blacklist和whitelist等非包容性术语来表达对黑人社区的支持。

Github

主分支从 master 改为 main

适用范围: 目前新建的项目已修改,老项目不做变更

Redis

目前的变化

  • 将 master-slave 架构的描述改为 master-replica
  • 为 SLAVEOF 提供别名 REPLICAOF,所以仍然可以使用 SLAVEOF,但多了一个选项
  • 保持继续使用 slave 来对 INFO 和 ROLE 进行回应,现在目前看来,这仍然是一个重大的破坏性变更

计划中的变化

  • 编写一个 INFO 的替代品
  • 在内部替换很多东西,因为技术原因,如果作了改动,许多 PR 也会无法应用,所以必须在某些地方进行大变动

目前的变化适用于 redis 5.0, 5.0以前不做变更,5.0以后可能还会有变更(6.0目前没有大变更)

Python

master process 变更为 parent process

适用范围: python 3.8及其以上

记录一次celery消费失败的问题排除

0x00

昨天发完UAT后,今天惯例点进UAT看看服务的情况,突然发现flower监测的celery竟然有半数以上的失败!

开始排查

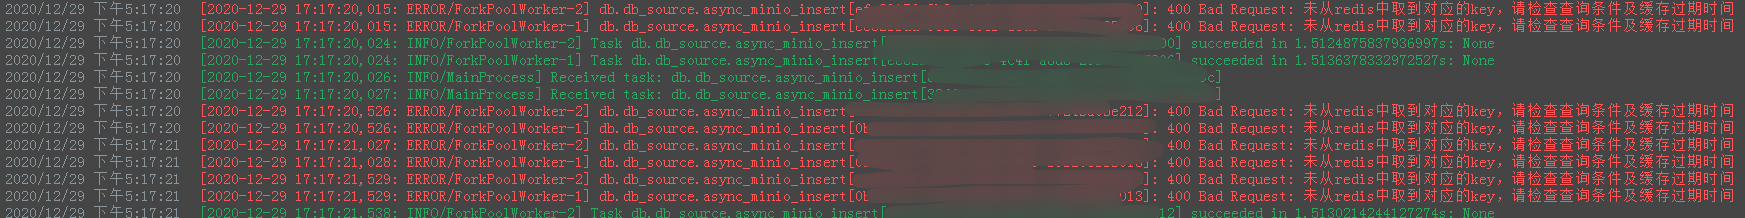
马上查看这个queue的日志,确实是有一堆失败的。

当前这个queue的业务是从redis里把数据取出来写入minio里落盘,但是涉及的数据均为几十k的数据,讲道理不应该会失败。

查询得到这几个失败的任务redis key的插入时间为2020-12-28 15:17:48,而消费的时间却是2020-12-29 17:17:21

这里就出现了一个问题,业务逻辑上当一个key塞入redis中后,马上会把落盘任务推到队列里,一般来说不会积攒这么久。但是此处竟然积攒到了一天以上才开始消费,而此处也因为我们设置的redis单key最大过期时间为24小时,所以导致落盘任务失败,并且数据丢失了。

发现问题

那么到底是什么任务积攒在队列里积攒了这么久。。?经过和同事分析发现,因为此次发版前还没有上线深度学习的功能,所以只分配了两个通用消费者。当启动几个深度学习任务时,这么点消费者完全没有办法应付之后的任务了,导致简单的几十k数据落盘任务都需要积攒天级以上的时间才能完成。

所以,深度学习任务单独开个queue分流不阻塞其他任务,就解决了此次问题。。(感觉好蠢,浪费了一个上午

解决群晖使用百度云docker镜像提示登陆过期的问题

0x00

群晖中使用的百度套件是基于VNC + Linux版百度云打包的docker镜像实现的,但是作者因为稳定性原因通过修改检测更新的hosts方法将百度云版本锁定在3.0.1.2版本。可是这在部分机器上不生效,那么我们反之道而行,自己更新容器里的百度云版本。

解决方案

  1. 去百度云官网下载.deb版百度云: 下载地址

  2. 将下好的镜像放到群晖已挂载的baidudownload文件夹里

  3. 进入容器中的baidudownload目录

  4. 执行 sudo dpkg -i baidunetdisk_3.4.1_amd64.deb

  5. 将hosts文件中127.0.0.1 update.pan.baidu.com这一行注释掉

然后群晖中的百度云套件就不报登陆过期的问题了

群晖中使用破解版 emby

0x00

本文基本来源 Yukino’s 理想乡 的 emby 破解版完全食用方法

但是文中没有提供 docker 版的安装方法和相关配置!!所以这里完善一下!

套件版方案使用起来很舒服,但是需要 fan 墙刮削。docker 版可以以一种巧妙的方式刮削,但是配置起来麻烦。

套件版 emby 破解

  1. 因为使用 emby 套件源,在国内难以访问,所以我们从官网上下载 emby 并安装

  2. 安装好后关闭 emby

  3. 使用脚本破解 wget https://neko.re/wp-content/uploads/simple-file-list/NyaaHost.sh ; sh NyaaHost.sh (再次鸣谢Yukino’s 理想乡)

  4. 进入并配置 emby

  5. 使用 Chrome 安装 URLRedirector(Chrome, Firefox) 插件,添加用户规则 原始地址 https://mb3admin.com ,目标地址 https://crackemby.neko.re ,然后确认并保存,别忘了勾选重定向。

  6. Chrome 访问 emby 地址,emby 高级版秘钥里随便填个字符串点保存就破解成功了~!

Docker 版 emby 安装及破解

先附上容器启动命令

docker create \
–name=emby \
–device=/dev/dri/renderD128:/dev/dri/renderD128 \
–device=/dev/dri/card0:/dev/dri/card0 \
-p 
yukinococo/emby_crack:unix-x64

Python 中的上下文管理

0x00

当我们执行语句块前需要一些准备动作,在执行完成之后又需要执行一些收尾动作。比如:文件读写后需要关闭,数据库读写完毕后需要关闭连接,资源加锁解锁等情况。对于这种情况 python 提供了上下文管理的概念,可以通过上下文管理器处理代码块执行前的准备动作,以及执行后的收尾动作。

使用 with 语句

先来看看不使用上下文管理器的情况

f = open("log.txt", "w")

try:
    f.write("hello")
finally:
    f.close()

使用上下文管理器

with open("log.txt", "w") as f:
    f.write("hello")

当结束语句的时候,Python 会自动的帮我们调用 f.close()方法

With 语句内部帮我们做了什么呢?

  1. with 后面的 open("log.txt", "w") 语句返回对象的__enter__方法会被调用,并把__enter__的返回值赋值给as后面的变量

  2. 当with执行完之后,会调用前端返回对象的__exit__方法。

让我们写个类测试一下:

class ContextTest:
    def __enter__(self):
        print("进入enter!")
        return "Foo"

    def __exit__(self, *args, **kwargs):
        print("进入exit!")


def get_sample():
    return ContextTest()


with get_sample() as sample:
    print(f"Sample: {sample}")

运行结果:

进入enter!
Sample: Foo
进入exit!

自己实现一个上下文管理器

通过__enter__和__exit__实现

根据上面 with 语句的原理,我们自己使用类实现一个支持 with 语句的打开文件的类

设计架构

Spark vs Dask Python生态下的计算引擎

本文基于Gurpreet Singh大佬在 Spark+AI SUMMIT 2020 的公开课编写

0x00

对于 Python 环境下开发的数据科学团队,Dask 为分布式分析指出了非常明确的道路,但是事实上大家都选择了 Spark 来达成相同的目的。Dask 是一个纯 Python 框架,它允许在本地或集群上运行相同的 Pandas 或 Numpy 代码。而 Spark 即时使用了 Apache 的 pySpark 包装器,仍然带来了学习门槛,其中涉及新的 API 和执行模型。鉴于以上陈述,我们下面将对比这两个技术方案。

Spark vs Dask

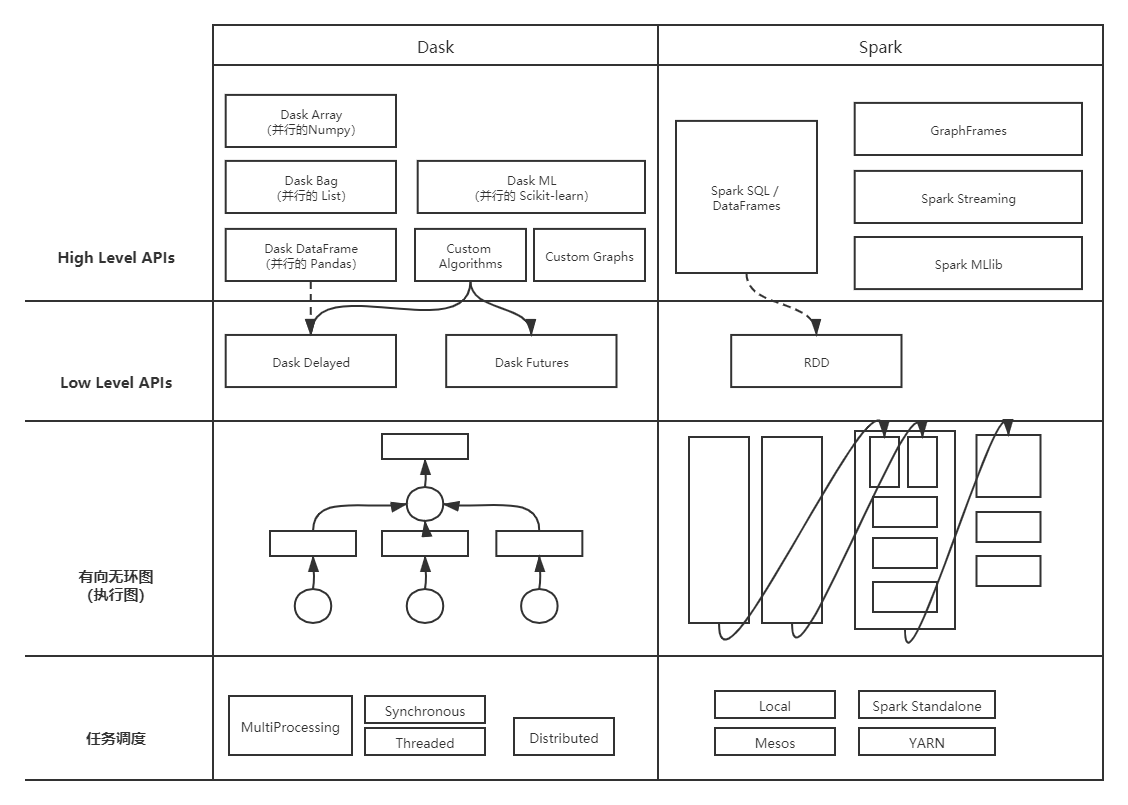
首先先上Dask和Spark的架构设计图~ 设计架构

生态

Dask 对于 Python 生态中的 Numpy、Pandas、Scikit-learn等有很好的兼容性,并且在low level api中提供了延迟执行的方法。

Spark 是独立于 Python 生态的另一个项目,但如果是在 JVM 环境下开发,并且十分需要使用 Spark SQL 等特性,可以考虑使用Spark。

性能

Dask 中的 dataframe 基本上由许多个 pandas 的 dataframe 组成,他们称为分区。但是因为 Dask 需要支持分布式,所以有很多 api 不完全和 pandas 中的一致。并且在涉及到排序、洗牌等操作时,在 pandas 中很慢,在 dask 中也会很慢。除此之外,dask 几乎都是遵循 pandas 设计的。

在线、离线激活鉴权实战

任务目标

实现一个客户端通过给与的指定激活码,激活仅限当前机器使用具体软件的功能。客户端可能处于能连接互联网和无法连接互联网两种情况。同时均要实现在指定时间使权限过期的功能,激活码在使用时才开始计时。

在线激活模式

这个就非常简单了,使用最简单的哈希加盐就可以实现了,与正常 REST 接口的哈希加盐验证只有,验证服务器端需要预先存好设置的激活码这一步。

激活码有效期就通过一个取巧的方法,将有效期的秒数转换成16进制,埋藏在序列号的指定段上。 在将当前时间和过期时间一起加盐,实现用户无法通过修改或锁定系统时间破解我们的系统。

当然,激活后,也要每隔一段时间验证一下是否过期,并且同时更新验证的时间戳,防止用户修改或锁定系统时间。

可以将鉴权放在请求前检验登录情况的装饰器里,每次更新只更新到flush里,在其他操作commit的时候再更新到数据库,防止一个请求里多个commit会导致数据无法回滚。

比较有风险的一点就是,用户可能会抓包服务端发到客户端的鉴权结果请求,然后伪造成功信息实现越过真实的鉴权结果,所以我们要设置一些比较特殊的字符串成功信息的字符串。或者可以实现类似银行电子狗,客户端-服务端均会随时间产生的相同动态加密校验码,与成功或失败信息加密后,再返回给客户端,保证中间过程即时被抓包,也无法破解。以下伪代码不考虑此过程

# 激活部分client伪代码

def online_active():
	# 前端传递激活码
	serial_number = form.serial_number.data

	# 获取本机硬件信息
	device_info = get_device_info()

	# 盐
	secret = config.secret

	# 记录激活码过期时间

	expire_time = int(serial_number[6:], 16) * (60 * 60 * 24)
	expire_timestamp = now_timestamp + expire_time

	# 硬件信息加盐生成的指纹
	signature = md5(device_info, expire_timestamp, now_timestamp, secret)

	# 向激活服务器发起验证请求
	if verify_license(serial_number, device_info, expire_timestamp, now_timestamp, signature):

		# 写入数据库
		insert_active()
		return True
	else:
		return False
# 激活部分server伪代码

def verify_license(serial_number, device_info, expire_timestamp, now_timestamp, signature):

	# 验证是否存在对应的激活码
	if serial_number in db:
		# 与客户端一致,只要验证指纹是否一致就行了
		if signature == md5(device_info, expire_timestamp, now_timestamp, secret):
			return True

	return False
# 客户端检测权限是否仍然有效
def is_active():
	# 验证激活设备是否改变,同时验证了激活时间是否被篡改

	timestamp_or_false = is_active_equipment()

	if not expire_timestamp_or_false:
		return False

	# 获取下面每次鉴权写入数据库的时间last_timestamp,防止用户篡改系统时间,躲避过期机制
	expire_timestamp, last_timestamp = expire_timestamp_or_false

	# 是否因为超过过期时间而过期
	if now_time > expire_timestamp:
		return False

	# now_time 为当前系统时间
	# 防止用户锁定时间
	if last_timestamp >= now_time:
		return False

	# 更新数据库中的now_timestamp并重新生成指纹
	now_timestamp = now_time
	signature = md5(something)

	# 写入数据库
	insert_active()
	return True


# 客户端检测是否设备是否改变

def is_active_equipment():
	# 其实就是重复哈希加盐鉴权的过程,只不过是将验证客户端指纹、验证服务器指纹改为了,
	# 客户端指纹、客户端数据库指纹鉴权了

	db_signature, serial_number, expire_timestamp, now_timestamp = get_db_signature()

	# 获取本机硬件信息
	device_info = get_device_info()

	# 盐
	secret = config.secret

	# 硬件信息加盐生成的指纹
	signature = md5(device_info, expire_timestamp, now_timestamp, secret)

	if signature == db_signature:
		return expire_timestamp, now_timestamp
	return False

离线激活模式

这里逻辑就比较恶心,但是还是类似上面在线激活的思想。只不过从客户端-激活服务器改为了客户端-手机-激活服务器。

Redis 主从复制 哨兵模式实战

0x00

项目中因为并发不是很高一直偷懒用的单节点 Redis ,但是有很多大 key 写入的场景,这样会影响读性能,于是准备做主从复制,顺便做一下哨兵模式。

Redis 主从复制配置

这里很简单,只需要配置slaveof <masterip> <masterport>参数即可实现。

注: Redis 5.0 版本后建议使用replicaof代替slaveof。 因为奇妙的政治正确原因,迫使作者修改了配置名,虽然slaveof仍能使用,但是只是暂时的兼容方案。

修改后重启 Redis 查看配置显示, 表示成功

# Replication
role: slave
master_host: 192.168.14.130
master_port: 6379
master_link_status: up
...

Redis 哨兵模式配置

必要配置如下

port 26379

# 当前哨兵绑定的ip,一般为本机ip
bind 192.168.2.210

# 设置master节点为 192.168.14.130 6379 上的redis,
# 别名为redis-master,当两个哨兵同意故障转移就会执行
# 一般设置N/2+1(N为哨兵总数)
sentinel monitor redis-master 192.168.14.130 6379 2

# 认为master节点断线所需的毫秒(SDOWN)
sentinel down-after-milliseconds redis-master 5000

# 如果在 180000 毫秒内 master 节点没有恢复,则认为是真正宕机
# 当下一次检测宕机 master 节点恢复后,则并入 slave 中
sentinel failover-timeout redis-master 180000

# 当 master 宕机后,最多可以多少个节点对新 master 进行同步
# 数字越小完成故障转移的时间越长
sentinel parallel-syncs redis-master 2

配置成功后显示如下

算法题基本框架 - Python实现

二叉树

DFS

二叉搜索树的中序遍历即为这棵树叶子节点值从小到大的排列

def dfs(root: TreeNode):
	if not root:
		return

	# 先序遍历
	dfs(root.left)
	# 中序遍历
	dfs(root.right)
	# 后续遍历

BFS

 from collections import deque

def bfs(root: TreeNode, target: TreeNode):
    queue = deque()
    # 记录访问的节点避免走回头路
    vistied = []

    # 起点在循环外入队
    queue.append(root)
    vistied.append(root)
    step = 0

    while queue:
        # 先记录此时队列长度,避免将新入队元素算入本次循环
        length = len(queue)
        for i in range(length):
            cur = queue.popleft()

            # 判断是否到达终点(此处需改成符合题意的条件)
            if cur is target:
                return step

            # 将cur相邻节点入队,adj()泛指cur相邻节点
            for x in cur.adj():
                if x not in vistied:
                    queue.append(x)
                    vistied.append(x)
        step += 1

二叉堆

数组表示(从0开始)的二叉堆有如下性质: